MachineHealthCheck
Для группы узлов Control Plane на вкладке MachineHealthCheck можно:
- настроить разные конфигурации MachineHealthCheck для проверки работоспособности машин. При инсталляции клиентского кластера монтируется дефолтная MachineHealthCheck для групп Control Plane узлов. Для конфигурации дополнительных MachineHealthChecks, нажмите + Добавить. Когда создано несколько конфигураций, на вкладке отображается список MachineHealthChecks.
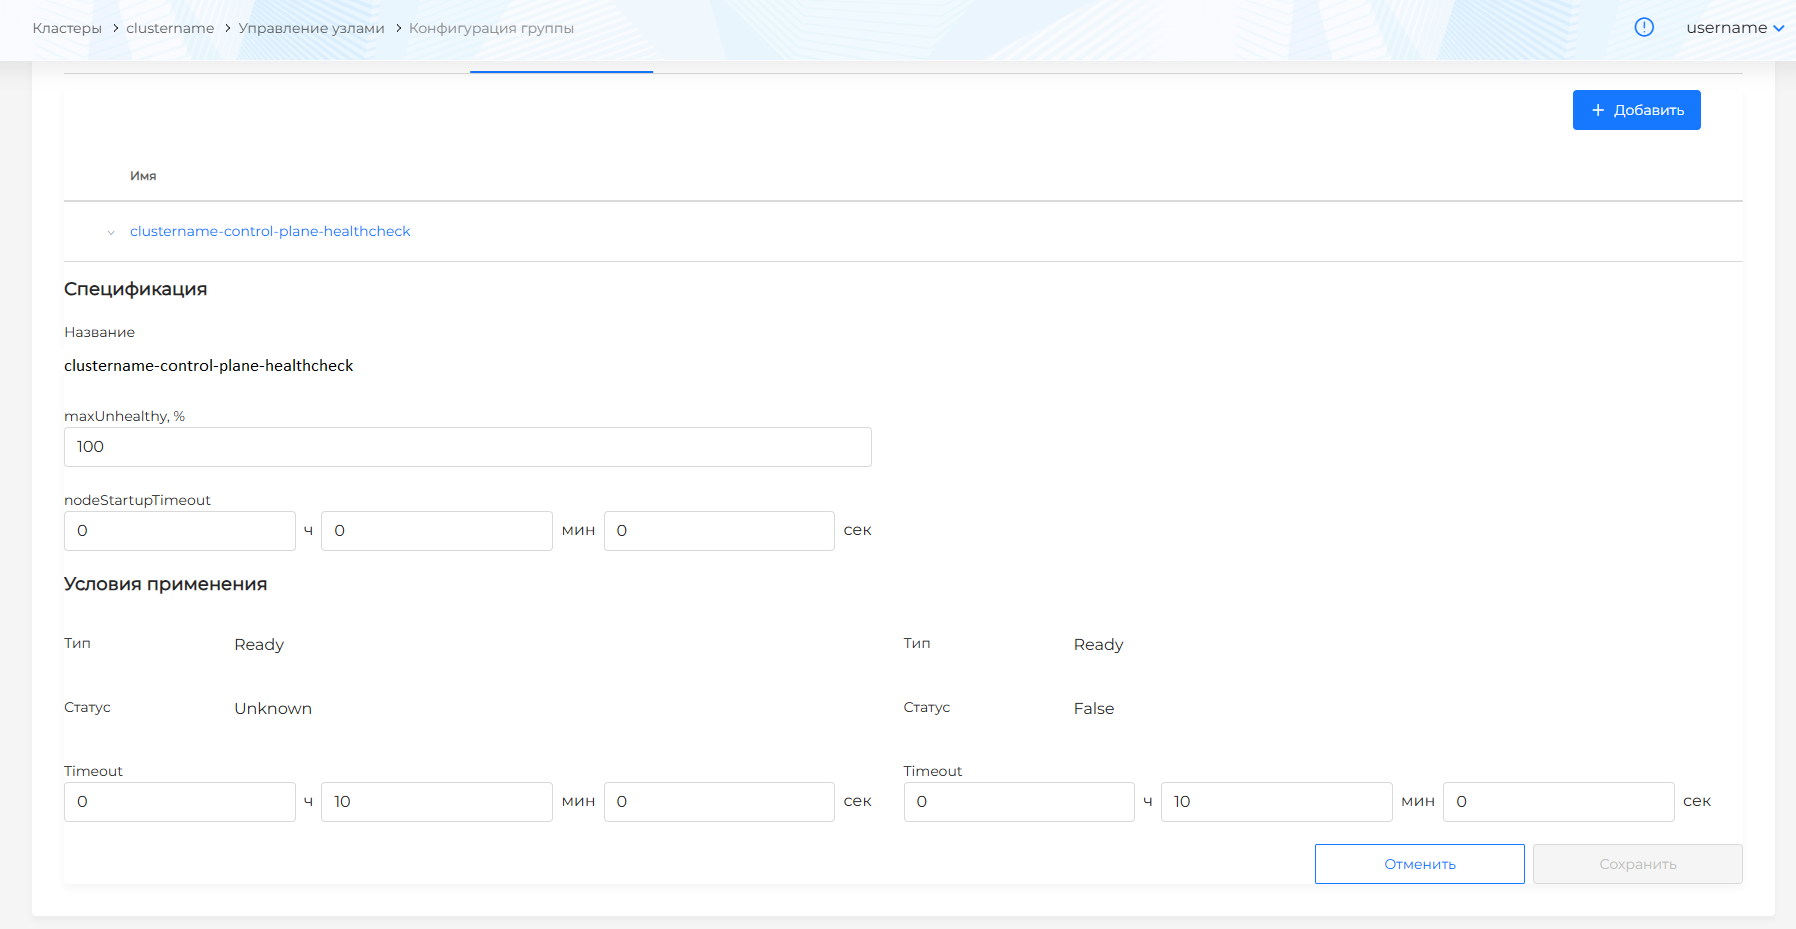
- перейти к просмотру и редактированию конфигурации MachineHealthCheck.
Скриншот
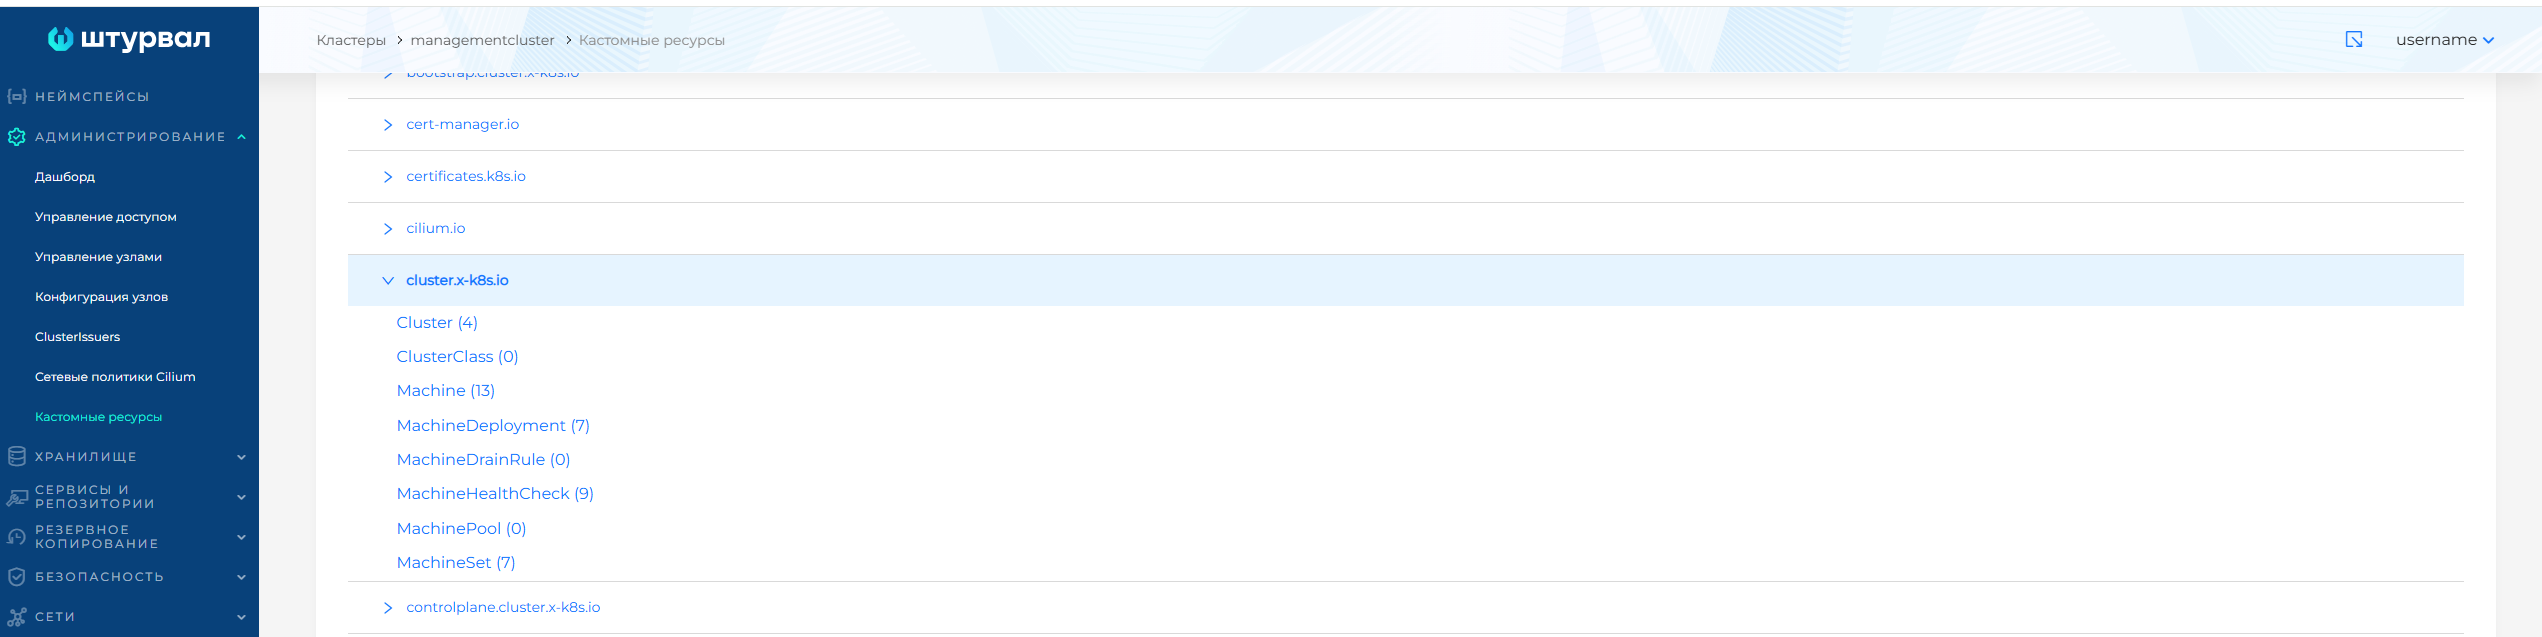
Детальнее параметры MachineHealthChecks можно настроить в кластере управления в разделе Администрирование/Кастомные ресурсы с помощью кастомного ресурса MachineHealthCheck в API-группе cluster.x-k8s.io.
Скриншот
Чтобы настроить конфигурацию MachineHealthCheck:
- задайте название MachineHealthCheck. После сохранения название нельзя изменить.
- можно задать maxUnhealthy в %. Параметр определяет максимальный процент нездоровых узлов в группе.
Обратите внимание! MachineHealthCheck не будет восстанавливать узлы, если количество нездоровых Control Plane узлов в группе больше, чем задано в maxUnhealthy.
Примеры
1. Значение maxUnhealthy - 90%:

В группе 3 Control Plane узла, где 2 узла нездоровы. Следовательно, количество нездоровых узлов = 66%, что меньше установленного значения *maxUnhealthy*. В этом случае узлы будут восстановлены.

2. Значение maxUnhealthy - 40%:

В группе 3 Control Plane узла, где 2 узла нездоровы. Следовательно, количество нездоровых узлов = 66%, что больше установленного значения *maxUnhealthy*. В этом случае узлы не будут восстановлены.
- можно задать nodeStartupTimeout время ожидания присоединения узла к кластеру. Слишком маленькое значение может привести к тому, что виртуальной машине не хватит времени для создания и присоединения, попытки присоединить узел уйдут в цикл.
Пример
Значение nodeStartupTimeout - 10 мин:

В этом случае, прежде чем считать узел нездоровым, должно пройти 10 минут.
Ожидается, что этого времени достаточно для присоединения узла к кластеру.
- в блоке Условия применения (unhealthyConditions) настройте параметры проверки узлов, при соблюдении которых узел будет считаться нездоровым:
- выберите Тип состояния узла. Доступные типы: NetworkUnavailable, DiskPressure, MemoryPressure, PIDPressure, Ready.
- выберите Статус состояния узла: True, False, Unknown.
- задайте Timeout - время ожидания, по истечению которого статус узла будет считаться действительным. Рекомендуется не устанавливать слишком короткий период Timeout, чтобы не происходило ложного перезапуска, пока узел переходит в исправное состояние. Длительный период Timeout может привести к простоям рабочей нагрузки на неработоспособном узле.
Пример
Условия применения:

Тип - Ready
Статус - Unknown
Timeout - 5 мин
Тип - Ready
Статус - False
Timeout - 5 мин

MachineHealthCheck сработает, если при проверке выявлено, что по истечении 5 минут наступит хотя бы одно из условий:
  - узел находится в состоянии Ready-Unknown;
  - узел будет в состоянии Ready-False.
После создания MachineHealthCheck будет добавлен в список проверок на вкладке MachineHealthCheck.
Чтобы перейти к просмотру и редактированию, нажмите на строчку с названием MachineHealthCheck. В открывшемся окне можно изменить параметры maxUnhealthy, nodeStartupTimeout и Timeout в условиях применения MachineHealthCheck.
По завершению внесения изменений нажмите Сохранить.
Как отключить MachineHealthCheck
Отключите MHC у группы, чтобы машина не перезапускалась и не пересоздавалась, когда узел станет NotReady.
Временное отключение
На вкладке MachineHealthCheck в поле maxUnhealthy, % укажите 0 и нажмите Сохранить.
В этом случае условие восстановления невыполнимо, и автоматического пересоздания узлов не произойдет. Чтобы снова включить MHC, установите прежнее значение.
Обратите внимание! У Control Plane и у каждой Worker-группы есть MHC, поэтому 0 необходимо проставить для каждой группы, где требуется отключить MHC.
На постоянной основе
Удалите все MachineHealthCheck кластера. Команда может быть выполнена только из кластера управления. Неймспейс MHC соответствует имени кластера:
kubectl -n <имя-кластера> delete machinehealthchecks.cluster.x-k8s.io --all
Обратите внимание! Команда удаляет все MHC кластера: и Control Plane, и Worker-группы. Автоматическое пересоздание узлов не возобновится, пока MHC не будут созданы заново.