MachineHealthChecks
Обзор
MachineHealthCheck (MHC) — ресурс Cluster API (cluster.x-k8s.io), механизм для автоматического обнаружения и восстановления неработоспособных машин. При срабатывании условий (например, узел NotReady) MHC может перезапустить или пересоздать машину.
Где настраивать: Администрирование → Управление узлами → Конфигурация группы → вкладка MachineHealthCheck. Расширенное редактирование YAML — в кластере управления: Администрирование → Кастомные ресурсы → MachineHealthCheck.
По умолчанию при установке клиентского кластера создаётся MachineHealthCheck для группы Control Plane и отдельная проверка для каждой группы Worker. Можно добавить дополнительные конфигурации (+ Добавить).
Скриншот: MachineHealthCheck
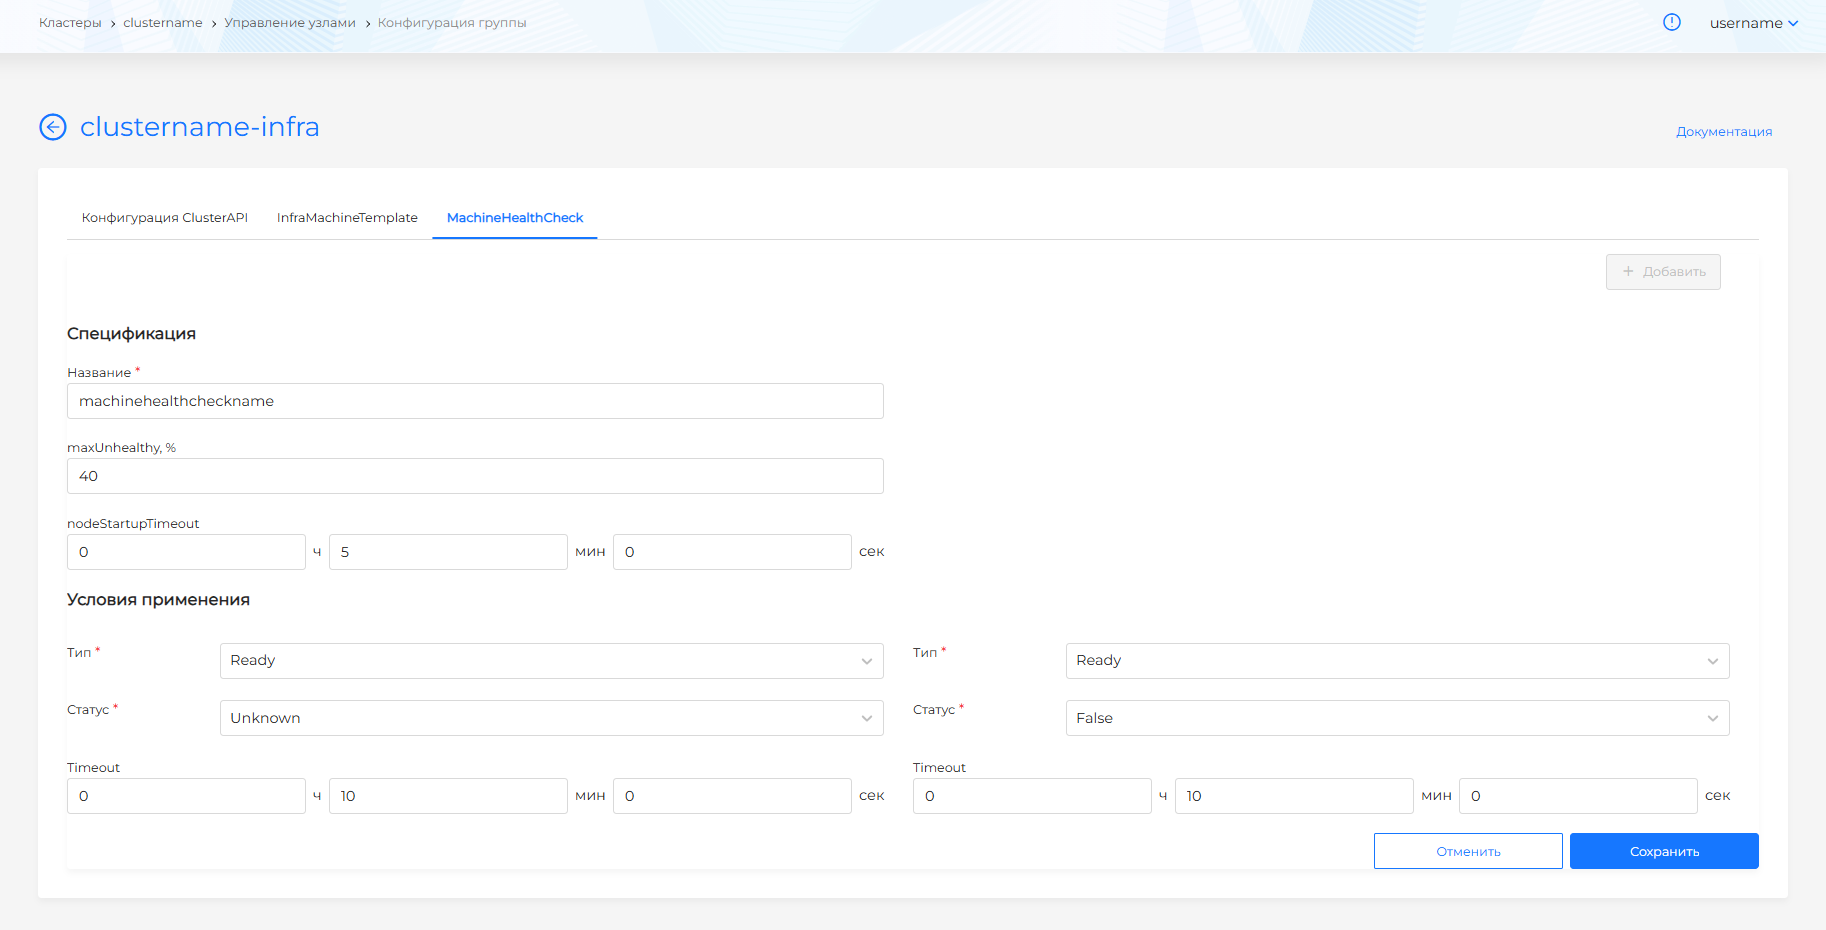
Параметры MachineHealthCheck
maxUnhealthy (%)
Максимальный процент нездоровых узлов в группе, при котором MHC будет восстанавливать узлы.
Обратите внимание! если нездоровых узлов больше maxUnhealthy, MHC не будет восстанавливать узлы (защита от каскадного удаления).
Значение 0 отключает восстановление: условие становится невыполнимым, и MHC не пересоздаёт узлы. Как задать его и как убрать MHC совсем — в разделе Как отключить MachineHealthCheck.
Примеры:
| maxUnhealthy | Узлов в группе | Нездоровых | Восстановление |
|---|---|---|---|
| 90% | 2 | 1 (50%) | Да |
| 40% | 2 | 1 (50%) | Нет |
| 50% | 4 | 2 (50%) | Да |
nodeStartupTimeout
Время ожидания присоединения нового узла к кластеру. Если узел не станет Ready за это время, он считается нездоровым.
Слишком маленькое значение может привести к тому, что ВМ не успеет создаться и присоединиться — MHC будет постоянно пересоздавать узлы (цикл).
Рекомендация: 10–15 минут в зависимости от провайдера и скорости создания ВМ.
Условия применения (unhealthyConditions)
Условия, при которых узел считается нездоровым:
| Параметр | Описание |
|---|---|
| Тип | NetworkUnavailable, DiskPressure, MemoryPressure, PIDPressure, Ready |
| Статус | True, False, Unknown |
| Timeout | Время ожидания, после которого условие считается действительным |
Рекомендация: не устанавливать слишком короткий Timeout — возможны ложные срабатывания при кратковременных сбоях. Слишком длинный Timeout — простой нагрузки на нерабочем узле.
Пример настроек:
- Тип: Ready, Статус: Unknown, Timeout: 5 мин
- Тип: Ready, Статус: False, Timeout: 5 мин
MHC сработает, если по истечении 5 минут узел в состоянии Ready=Unknown или Ready=False.
Создание и редактирование MHC
- На вкладке MachineHealthCheck нажмите + Добавить.
- Задайте название (после сохранения изменить нельзя).
- Укажите maxUnhealthy, nodeStartupTimeout и условия unhealthyConditions.
- Нажмите Сохранить.
Справочно: перечень ресурсов cluster.x-k8s.io, связанных с узлами, вместе с другими группами CAPI — на странице Создание узлов при развертывании клиентского кластера.
Как отключить MachineHealthCheck
Отключите MHC у группы, чтобы машина не перезапускалась и не пересоздавалась, когда узел станет NotReady.
Временное
В кластере перейдите в раздел Администрирование → Управление узлами → Конфигурация группы. На вкладке MachineHealthCheck группы узлов в поле maxUnhealthy, % укажите 0 и нажмите Сохранить.
Скриншот: maxUnhealthy, %
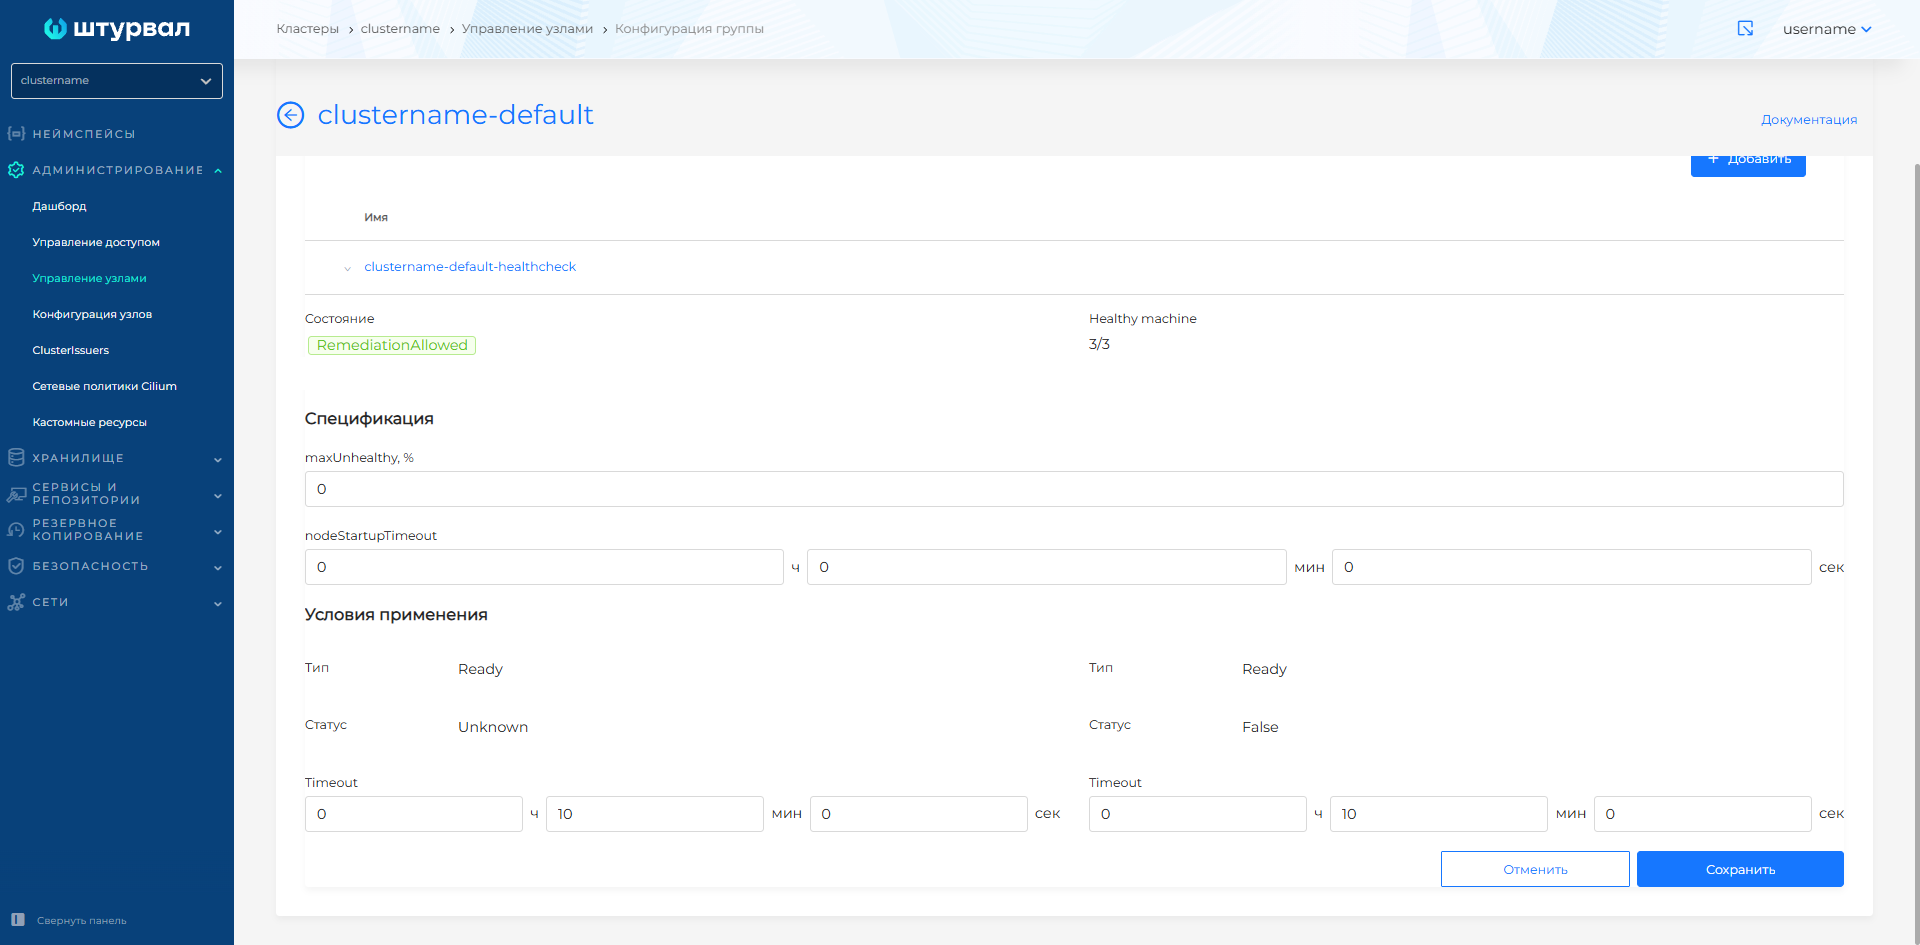
В этом случае условие восстановления невыполнимы и автоматического пересоздания узлов не произойдет. Чтобы снова включить MHC, установите прежнее значение.
У Control Plane и у каждой Worker-группы есть MHC, поэтому 0 необходимо проставить для каждой группы, где требуется отключить MHC.
На постоянной основе
Удалите все MachineHealthCheck кластера. Команда может быть выполнена только из кластера управления. Неймспейс MHC соответствует имени кластера:
kubectl -n <имя-кластера> delete machinehealthchecks.cluster.x-k8s.io --all
Команда удаляет все MHC кластера: и Control Plane, и Worker-группы. Автоматическое пересоздание узлов не возобновится, пока MHC не будут созданы заново.