Группы узлов
Обзор
Узлы кластера объединяются в группы. На странице Управление узлами отображаются:
- Control Plane — группа управляющих узлов;
- Workers — группы Worker-узлов (по умолчанию: Infra и Default).
Где настраивать: Администрирование → Управление узлами → вкладка Группы узлов.
Конфигурация группы здесь относится к Cluster API (число узлов, InfraMachineTemplate и т.д.) и не совпадает с разделом интерфейса Конфигурация узлов, где задаются NCI для ОС и компонентов на узлах — см. Конфигурация узлов (NCI).
Для каждой группы отображаются: количество узлов в группе и количество работающих (Ready) узлов.
Скриншот: группы узлов
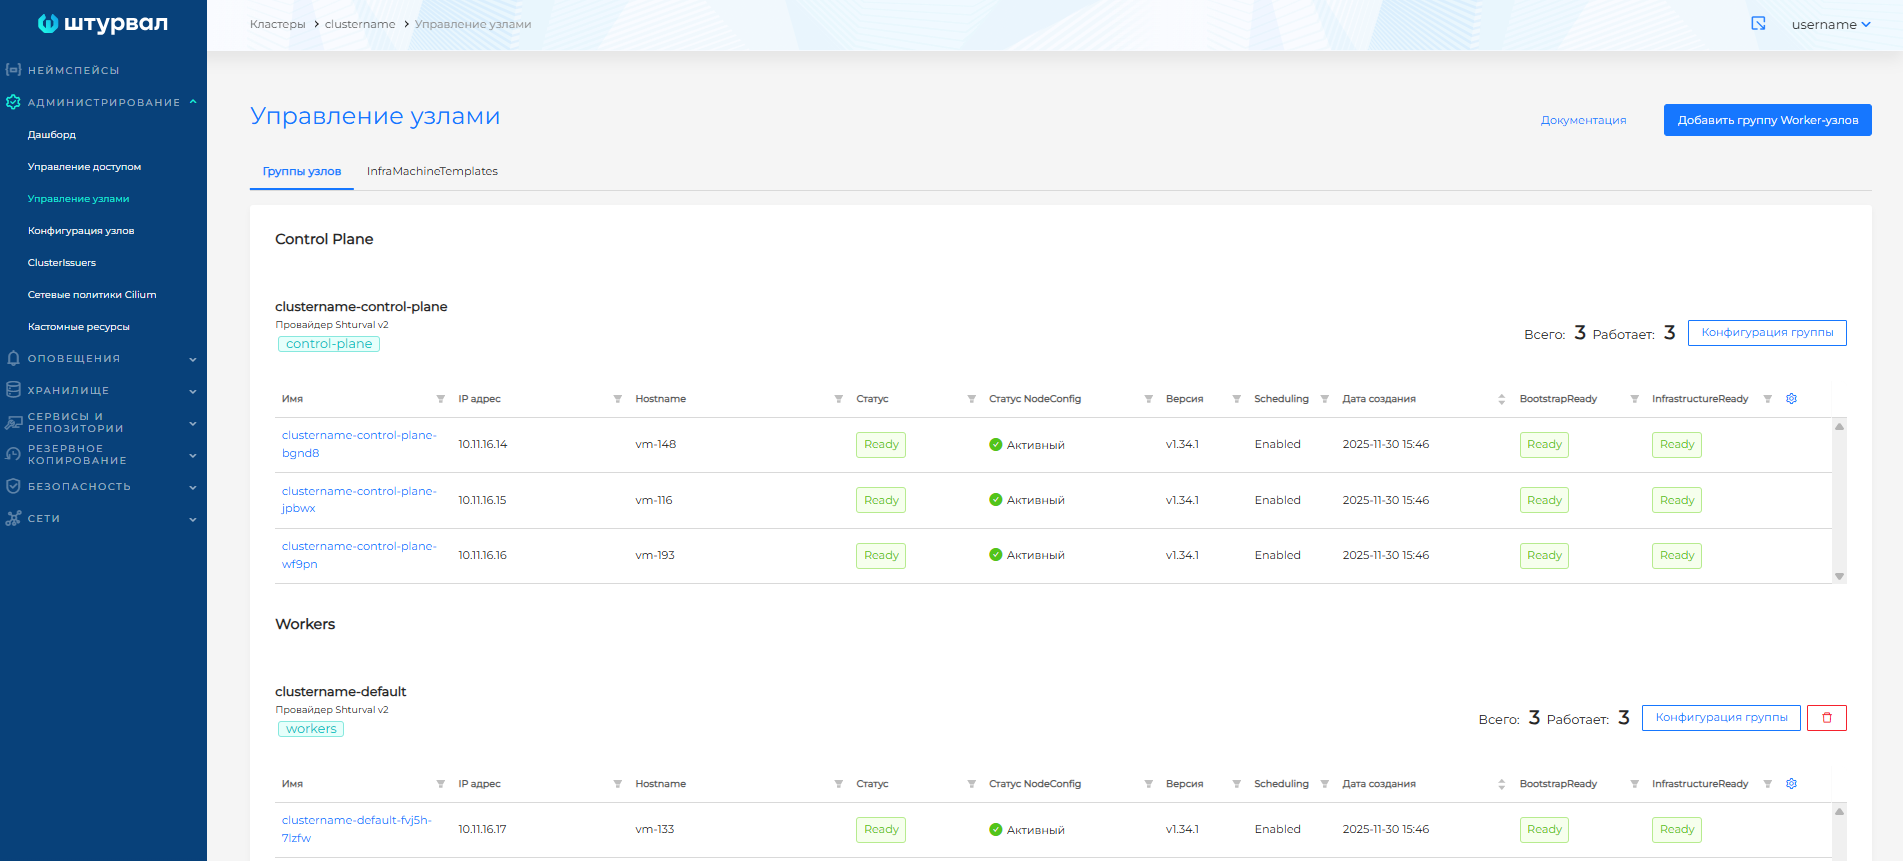
Клик по имени узла открывает страницу узла.
Группа Control Plane
В кластере создаётся ровно одна группа Control Plane — узлы с etcd и компонентами плоскости управления Kubernetes.
- Для тестовых кластеров обычно достаточно одного узла Control Plane.
- Для отказоустойчивости рекомендуется три узла (кворум etcd).
- Не рекомендуется увеличивать число узлов Control Plane более чем до трёх: это может замедлить кластер из‑за сложности достижения кворума etcd.
Состояние группы отображается на странице Управление узлами.
В кластере управления сведения о машинах группы можно также посмотреть в ресурсе MachineDeployment (API cluster.x-k8s.io) через раздел Администрирование → Кастомные ресурсы.
Обратите внимание! Внимание: уменьшение числа узлов Control Plane в кластере управления может привести к поломке кластера управления.
Группы Worker-узлов
Worker-группы — это узлы, на которых запускается рабочая нагрузка. По умолчанию создаются:
- Infra — предпочтительно для инфраструктурных сервисов (Ingress, мониторинг). При нехватке узлов сервисы могут разворачиваться в других группах.
- Default — для пользовательских нагрузок.
Можно создавать дополнительные группы (например, для GPU, изолированных приложений).
В гибридном кластере (основной провайдер — виртуализация или облако, дополнительные узлы — на хостах провайдера Shturval v2) новые Worker-группы могут создаваться с типом провайдера Shturval v2. Подробнее см. страницу Гибридные кластеры.
Состояние каждой Worker-группы можно отслеживать на странице Управление узлами.
Добавление группы Worker-узлов
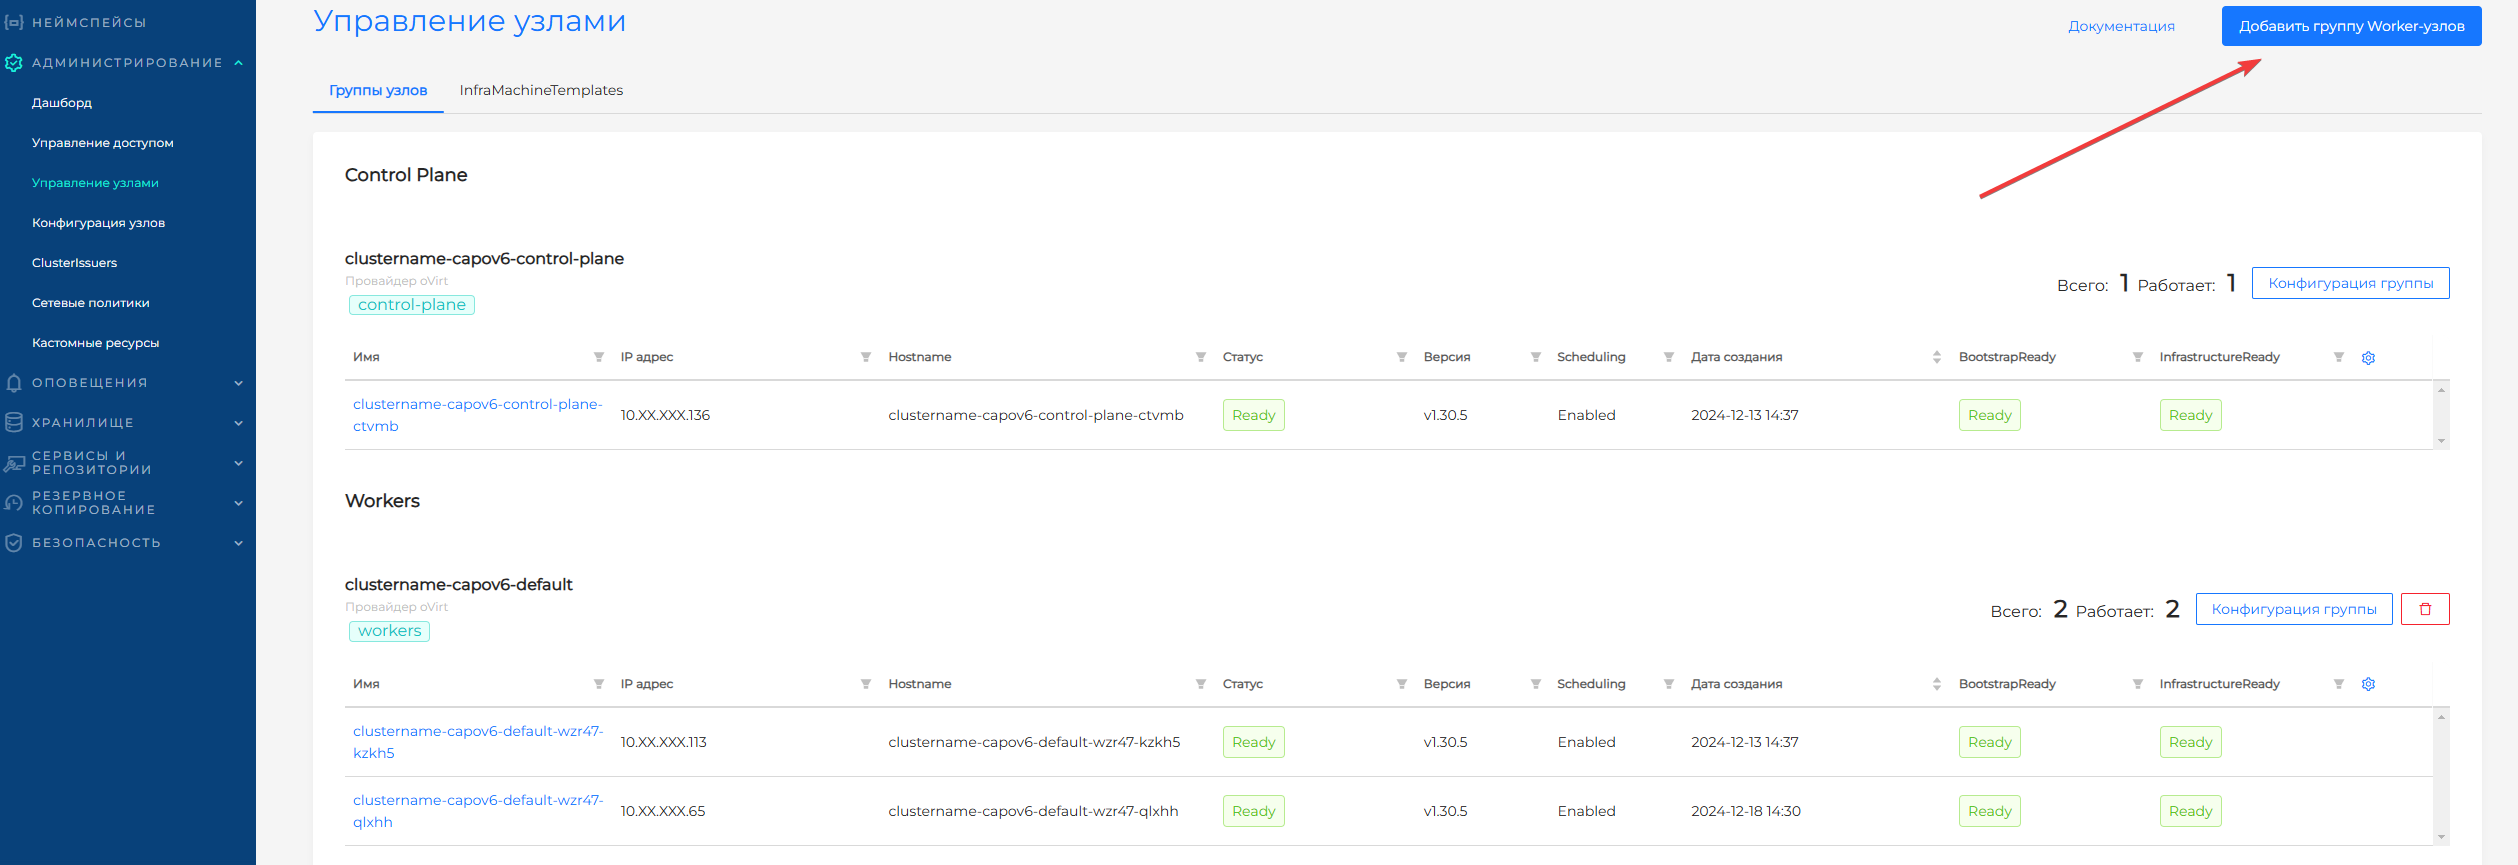
- Нажмите Добавить группу Worker-узлов.
- В кластерах не на Shturval v2: в поле Тип провайдера по умолчанию выбран провайдер кластера; при наличии экземпляра Shturval v2 можно выбрать Shturval v2.
- Заполните:
- Конфигурация Cluster API — способ масштабирования, количество узлов, тип восстановления;
- InfraMachineTemplate — CPU, память, диск, шаблон ВМ (зависит от провайдера) или параметры хостов / экземпляр провайдера для Shturval v2.
Обратите внимание! для групп Worker-узлов default и infra тип провайдера не выбирается. В созданной Worker-группы тип провайдера изменить нельзя.
Скриншот: создание группы
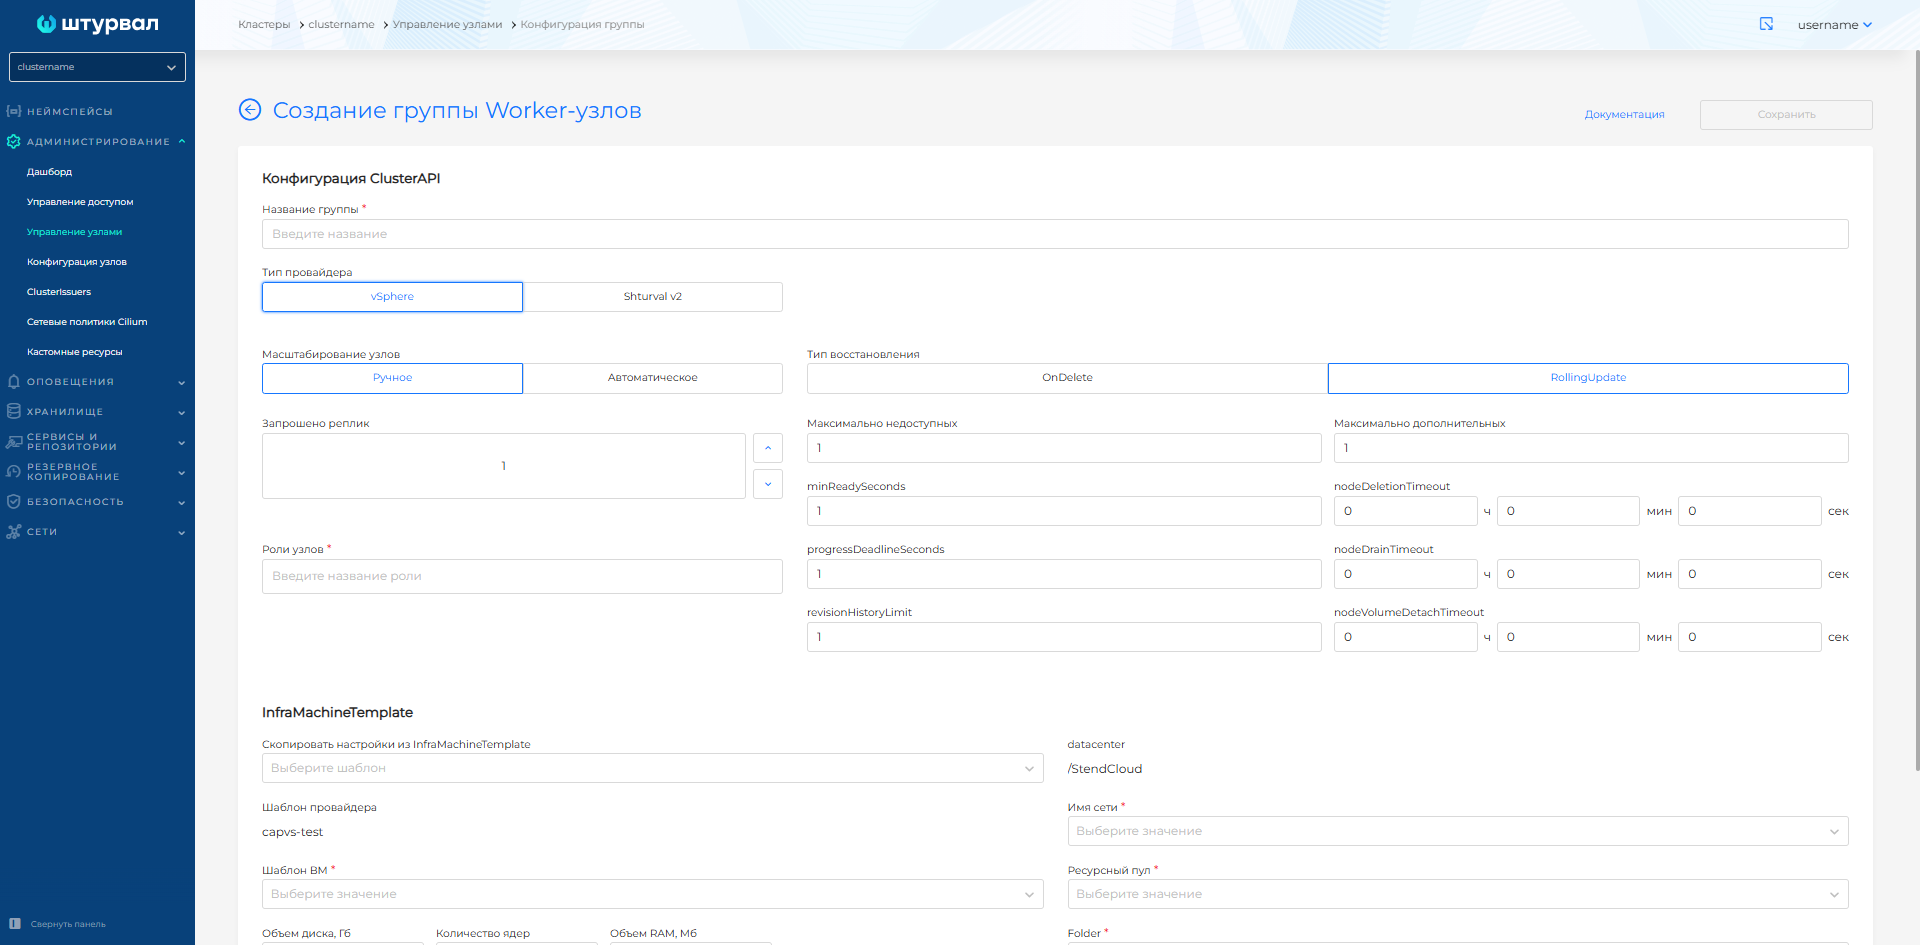
Конфигурация группы
Справа от названия группы нажмите Конфигурация группы. Доступны вкладки:
- Конфигурация Cluster API — количество узлов, автомасштабирование, тип восстановления;
- InfraMachineTemplate — ресурсы ВМ (CPU, RAM, диск), шаблон;
- Taints — ограничения планирования для всех узлов Worker-группы. Недоступно для группы Control Plane;
- MachineHealthCheck — автоматическое восстановление неработоспособных узлов.
Скриншот: конфигурация группы
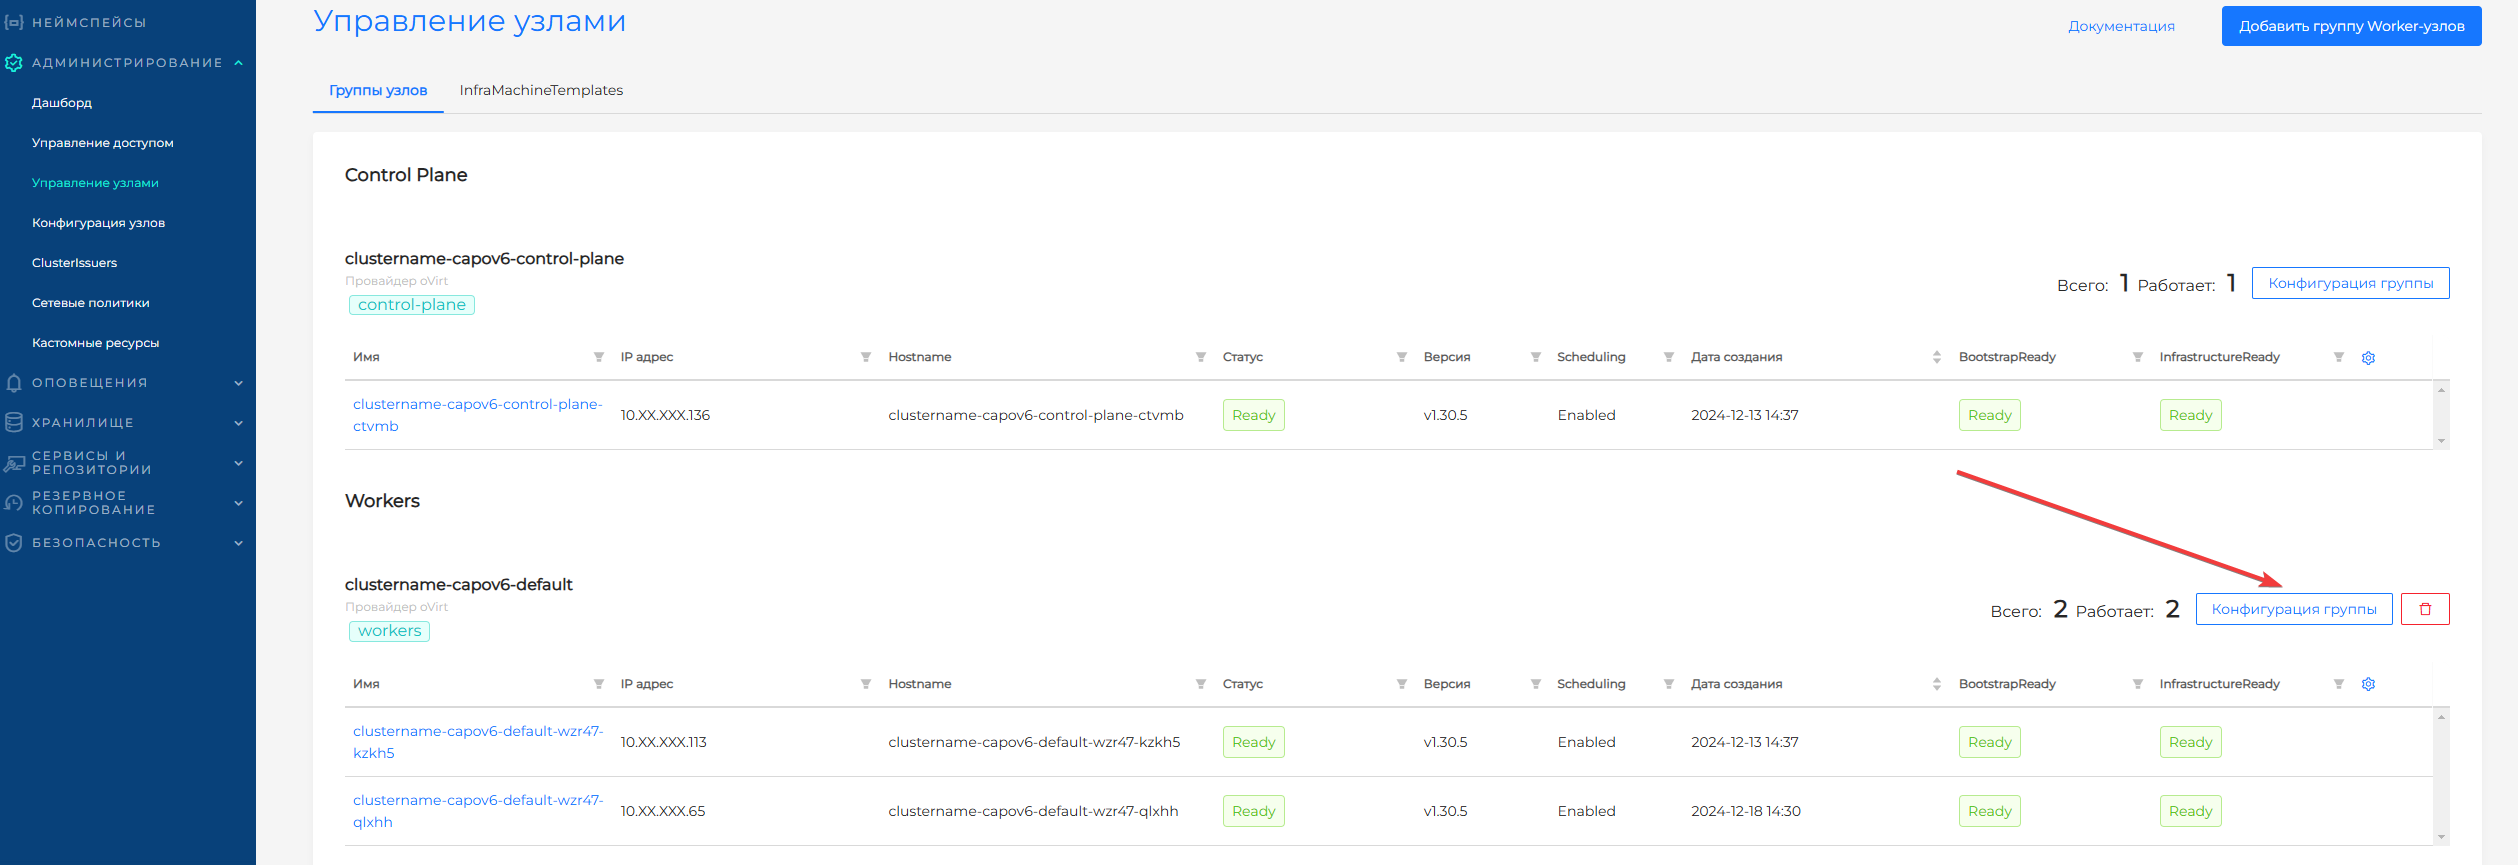
Конфигурация Cluster API
На вкладке Конфигурация Cluster API в интерфейсе задаются параметры Cluster API: для Worker-групп это прежде всего ресурс MachineDeployment, для группы Control Plane — KubeadmControlPlane (API controlplane.cluster.x-k8s.io). Детальный просмотр и правка YAML выполняются в кластере управления: Администрирование → Кастомные ресурсы.
Особенности переноса labels и taints из MachineDeployment и KubeadmControlPlane на узлы Kubernetes подробнее на странице Лейблы, аннотации и taints в Cluster API.
Способ масштабирования
| Режим | Описание |
|---|---|
| Ручное | Количество узлов задаётся вручную в поле «Запрошено реплик». |
| Автоматическое | Cluster Autoscaler изменяет количество узлов в заданном диапазоне (мин–макс). Минимум — 2 узла. |
Скриншот: автомасштабирование
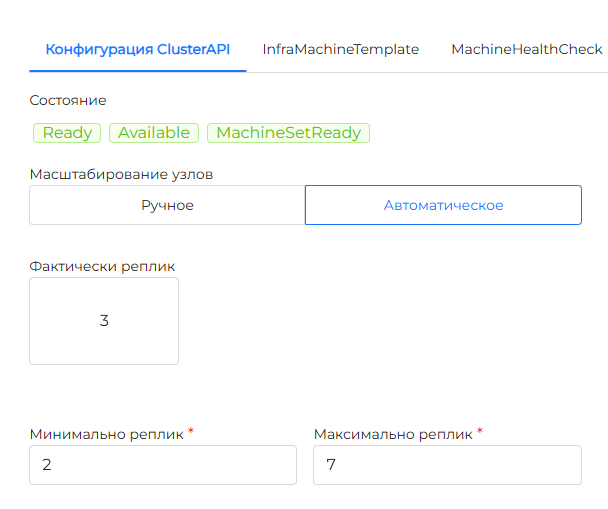
Подробнее про аннотации, scale-from-zero и ограничения при удалении узлов — в справочнике Масштабирование узлов.
При необходимости вывести конкретный хост из группы с провайдером Shturval v2 используйте сценарий Высвобождение хоста.
Обратите внимание! Внимание: при превышении лимита Worker-узлов или vCPU по лицензии на экранах интерфейса отображается уведомление с просьбой обратиться к вендору.
Тип восстановления (Strategy)
| Тип | Описание |
|---|---|
| OnDelete | При изменении конфигурации старые узлы удаляются, новые создаются. |
| RollingUpdate | Рекомендуется. Новые узлы создаются с последовательной заменой старых. Нужно указать maxUnavailable и maxSurge. |
Дополнительные параметры
- minReadySeconds — минимальное время в секундах, в течение которого узел должен быть Ready, прежде чем реплика считается доступной. По умолчанию 0.
- progressDeadlineSeconds — максимальное время развёртывания (по умолчанию 600 с). При превышении — ProgressDeadlineExceeded.
- revisionHistoryLimit — количество MachineSets для отката (по умолчанию 1).
- nodeDeletionTimeout — как долго
capi-controller-managerбудет пытаться удалить узел после того, как ресурс Machine помечен на удаление. При значении 0 попытки повторяются бесконечно; если не задано — используется значение по умолчанию (10 с) для этого поля у Machine. - nodeDrainTimeout — суммарное время на Drain узла (0 — без ограничения). Отличается от
kubectl drain --timeout. - nodeVolumeDetachTimeout — время ожидания отсоединения томов (0 — без ограничения; у Machine по умолчанию для отсоединения часто задано 10 с).
- Роли — через запятую: каждая роль задаёт лейбл узла
node-role.kubernetes.io/<role>.
Параметры группы Control Plane на этой вкладке соответствуют ресурсу KubeadmControlPlane (controlplane.cluster.x-k8s.io). Имя ресурса обычно формируется как <имя-кластера>-control-plane.
- Запрашиваемое количество узлов — только нечётное число (etcd на узлах Control Plane; для кворума нужно нечётное количество). Для отказоустойчивости рекомендуется 3 или 5 узлов.
- Стратегия обновления: RollingUpdate — изменения применяются последовательно; задаётся MaxSurge (целое число узлов или процент).
- nodeDeletionTimeout, nodeDrainTimeout, nodeVolumeDetachTimeout — те же смыслы, что и для Worker (Machine): удаление узла после удаления Machine, ожидание Drain и отсоединения томов.
Параметры «лечения» после признания машины нездоровой:
| Параметр | Описание |
|---|---|
| maxRetry | Максимум повторных попыток исправления; если новая машина-замена снова ломается, считается новая попытка. По умолчанию не задано — попытки бесконечны. |
| retryPeriod | Пауза перед следующей попыткой после неудачи. По умолчанию — следующая попытка сразу. |
| minHealthyPeriod | После этого интервала машина считается «устаканившейся»; счётчик восстановлений сбрасывается (по умолчанию часто 1 ч). |
Внимание: не рекомендуется уменьшать число узлов Control Plane в кластере управления.
Taints
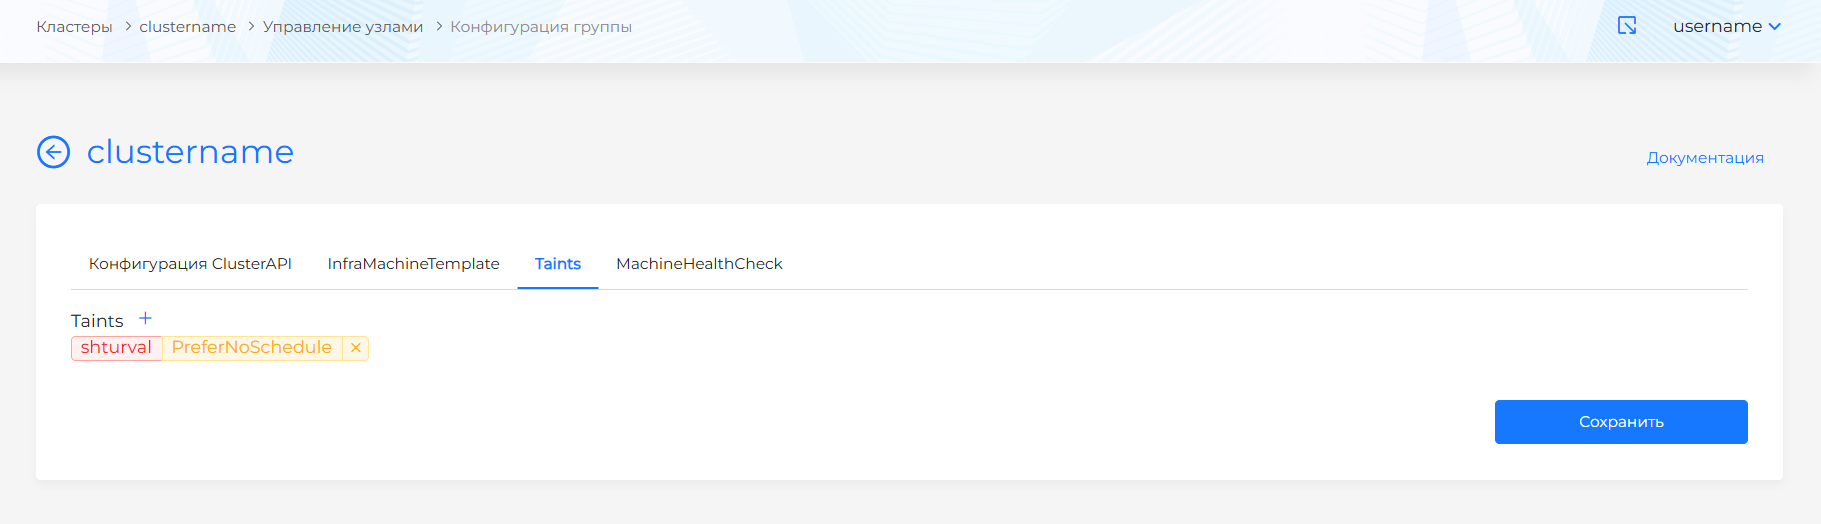
Taint на странице узла ограничивает только один конкретный узел. При пересоздании узла такой taint будет удален. Управление taints в конфигурации Worker-группы позволяет присвоить taints всем узлам группы. Можно добавить, изменить или удалить Taint.
| Поле | Параметр в манифесте | Описание |
|---|---|---|
| Ключ | key | Обязательное. Имя ограничения, по которому под понимает, что на узел ему нельзя без Toleration. |
| Значение | value | Необязательное. Уточняет значение ключа, например, dedicated=db. Поле можно оставить пустым. |
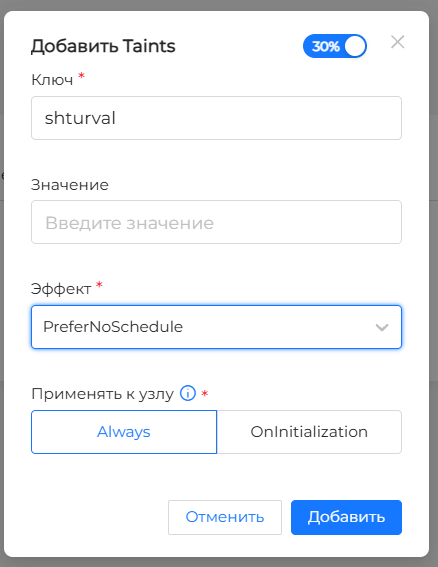
| Эффект | effect | Обязательное. NoSchedule — новые поды без Toleration на узел не попадут, существующие останутся. PreferNoSchedule — планировщик не планирует поды на узел, но при нехватке ресурсов под может быть запланирован. NoExecute — новые поды не планируются, а уже запущенные без Toleration будут вытеснены. Подробнее на странице Taints, Tolerations и Affinity. |
| Применять к узлу | propagation | Обязательное. По умолчанию AlwaysCluster API постоянно поддерживает taint на Node. Если удалить такой taint с узла вручную, Cluster API добавит его снова при реконсиляции. Если удалить taint из Machine, контроллер удалит его с Node.. Также можно выбрать OnInitializationTaint добавляется на Node один раз при инициализации. Если позже удалить его с Node, Cluster API не добавит его повторно. Если удалить такой taint из группы или переключить на Always, с текущих узлов он не снимется. |
Изменение taints в группе не пересоздаёт узлы. Новые taints передаются в управляемые Machine без rollout узлов. После этого они синхронизируются на Node по правилам propagation.
Чтобы под мог встать на какой либо узел из группы, в спецификации пода необходим Toleration на каждый taint группы. Tolerations задаются в шаблоне пода — см. Управление Tolerations в GUI.
В манифесте MachineDeployment тот же список лежит в spec.template.spec.taints. Пример, предел в 64 taint и ключи, которые задавать нельзя, — на странице Лейблы, аннотации и taints в Cluster API.
Скриншот: вкладка Taints группы
Скриншот: добавление Taint, поле «Применять к узлу»
InfraMachineTemplate
InfraMachineTemplate задаёт параметры виртуальных машин для группы. Тип шаблона зависит от провайдера. При создании узла Cluster API создаёт экземпляр InfraMachine (например VSphereMachine, ShturvalMachine) на основе шаблона — этот ресурс создаёт ВМ в инфраструктуре.
После обновления платформы до версии 2.15 включительно замените шаблон ВМ в InfraMachineTemplate каждой группы узлов, чтобы новые узлы создавались с актуальной версией Kubernetes.Начиная с версии 2.15 кластера при стратегии RollingUpdate потребуется добавить в экземпляр провайдера шаблон ВМ целевой версии Kubernetes для применения при обновлении. Пошаговая инструкция — на странице Узлы и шаблоны ВМ.
Обратите внимание! изменение InfraMachineTemplate в существующей группе приводит к пересозданию узлов.
Внимание: для провайдеров zVirt, oVirt, HostVM, РЕД Виртуализация, ROSA Virtualization, VMware vSphere, Yandex Cloud и VMware vCloud Director в выпадающем списке InfraMachinetemplate доступны все шаблоны ВМ, существующие в платформе провайдера инфраструктуры и к которым у сервисной УЗ есть права доступа. Используйте только те шаблона ВМ, которые подготовлены с помощью STC!!!
Основные параметры (общие)
| Параметр | Описание |
|---|---|
| CPU (cores/sockets) | Количество ядер, сокетов. |
| RAM (memoryMiB, sizeMb) | Объём памяти. |
| Диск (diskGiB, osdisksizegb) | Размер системного диска. |
| Шаблон ВМ (template) | Образ ОС. Рекомендуется использовать одну ОС в рамках кластера. |
Провайдеры и параметры
Подробное описание параметров для каждого провайдера — в Справочнике InfraMachineTemplate:
| Провайдер | Тип шаблона | Ключевые параметры |
|---|---|---|
| vSphere | VSphereMachineTemplate | datacenter, datastore, diskGiB, memoryMiB, numCPUs, networkName, resourcePool, folder, template |
| oVirt | OVirtMachineTemplate | cores, sockets, threads, sizemb, osdisksizegb, vnicprofile, ovirtcluster, template, Storage domain, клонирование диска (diskclone) |
| OpenStack | OpenStackMachineTemplate | cloudName, flavor, sshKeyName, volumeType, объём диска, template |
| Shturval v2 | ShturvalMachineTemplate | роль хостов или селектор по лейблам (In, NotIn, Exists, DoesNotExist) |
| Yandex Cloud | YandexMachineTemplate | тип платформы, тип диска, RAM, диск, cpuCores, template |
| Basis Dynamix | BasisMachineTemplate | ядра, RAM, диск, ресурсная группа, VINS, ExtNet |
| vCloud Director | VCDMachineTemplate | DiskSize, SizingPolicy, template |
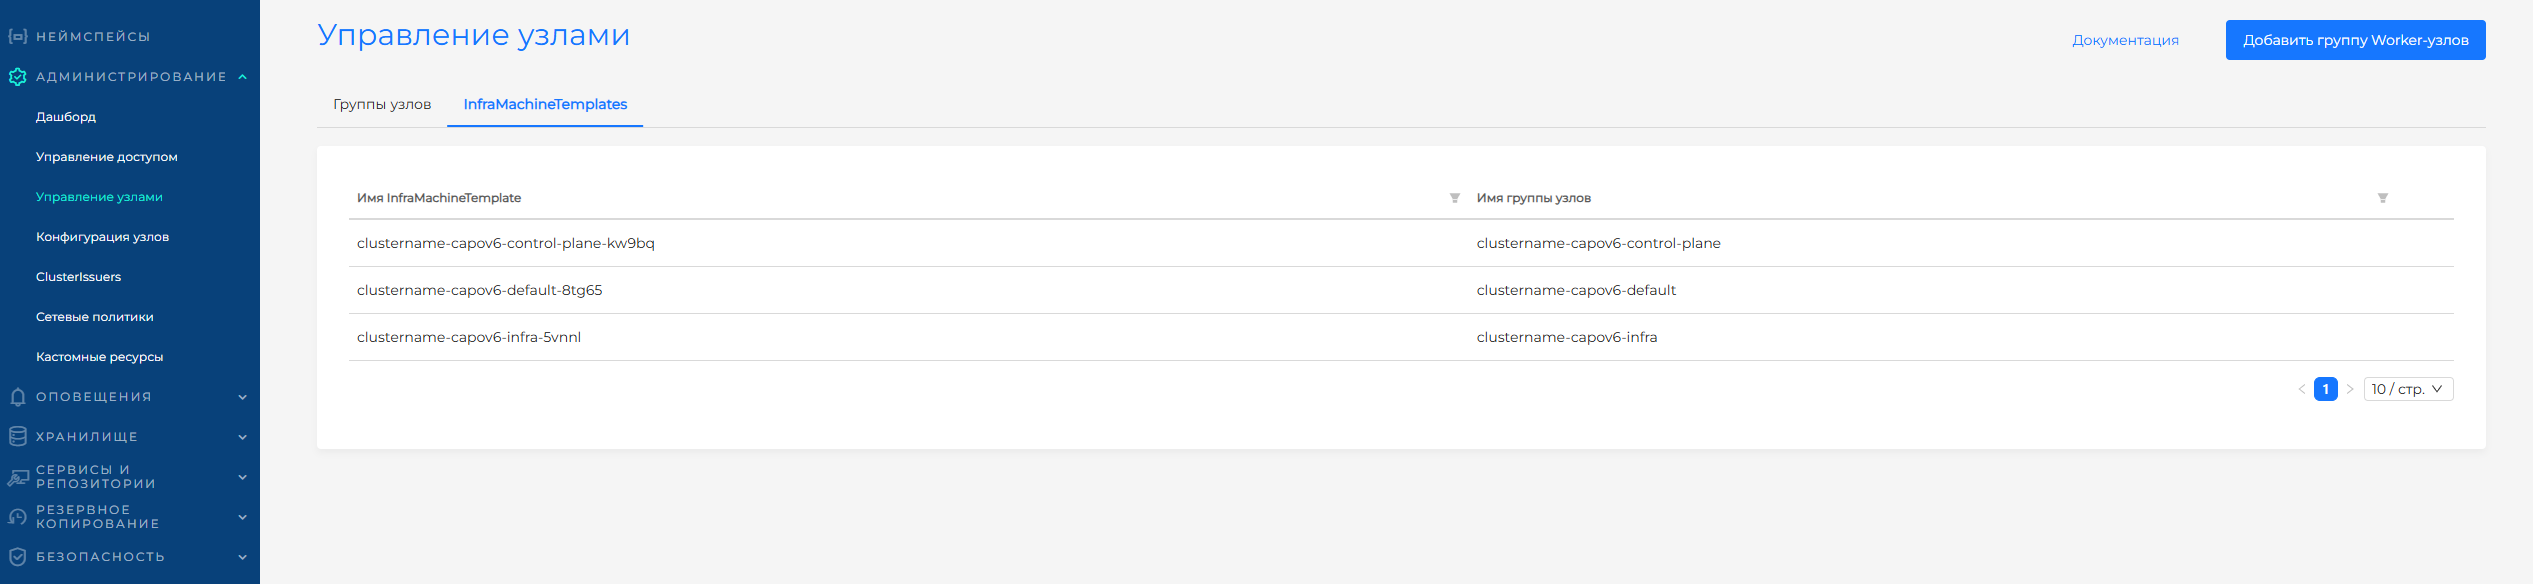
Скриншот: InfraMachineTemplates
Вкладка «Поды»
Вкладка содержит перечень подов всех узлов кластера: имя, контейнеры, рестарты, статус, неймспейс, родительская нагрузка, QoS, имя узла. Используется для отслеживания Drain и диагностики. Индикатор предупреждения рядом со счётчиком выводится, когда есть поды не в состоянии Running.
Доступна фильтрация по статусам, QoS и узлам. Для Failed нажмите на статус, чтобы увидеть дополнительную информацию о причинах ошибки.
Вкладка InfraMachineTemplates
На странице Управление узлами вкладка InfraMachineTemplates содержит все инфраструктурные шаблоны кластера. При изменении шаблона в конфигурации группы создаётся новый InfraMachineTemplate. Можно удалять шаблоны, не привязанные к группам.
Вкладка «Неопознанные узлы»
Отображается, если в кластере есть узлы без связи с Machine (Cluster API). Такие узлы можно удалить.